La NASA et IBM ont annoncé la publication du NASA-IBM Lunar Foundation Model, un système d’intelligence artificielle open source téléchargeable depuis Hugging Face. Cette mise à disposition s’accompagne d’un jeu de données que les chercheurs pourront utiliser pour entraîner leurs propres modèles. L’annonce a été faite un jeudi, sans qu’une date précise ne soit fournie dans les éléments disponibles.
Un modèle de fondation aux usages multiples
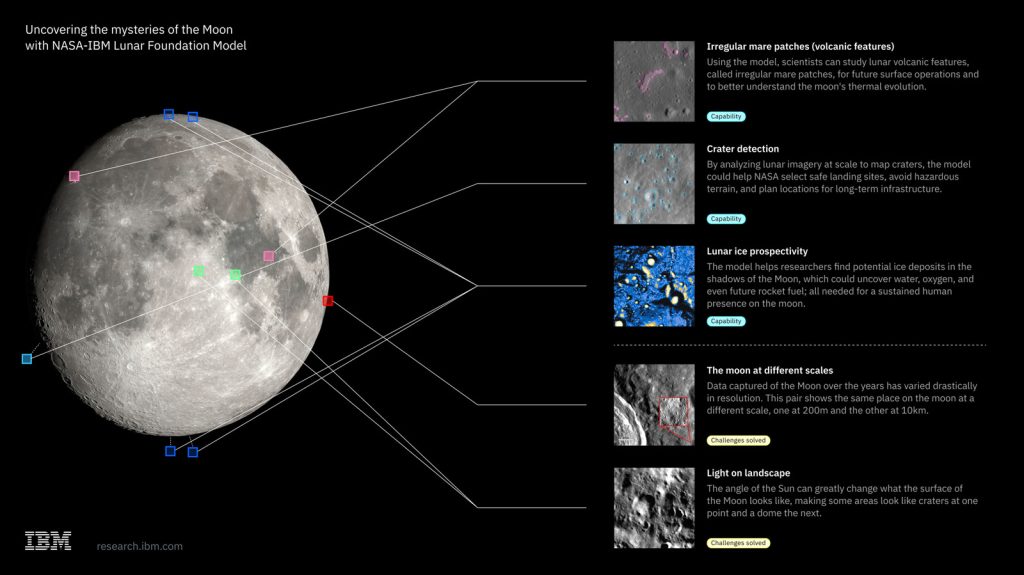
Le NASA-IBM Lunar Foundation Model appartient à la catégorie des modèles de fondation, capables d’accomplir plusieurs tâches après un entraînement initial. Selon Juan Bernabé-Moreno, directeur d’IBM Research Europe, Royaume-Uni et Irlande, il s’est révélé particulièrement performant pour repérer les zones de la surface lunaire susceptibles de contenir de la glace.
Pour évaluer cette capacité, la NASA et IBM ont comparé les prédictions du modèle à une carte construite à partir d’un flux scientifique publié, intégrant des données de terrain, thermiques et environnementales. Le modèle a ensuite été confronté à SwinV2-B, un système de vision entraîné par Microsoft pour le traitement d’images à haute résolution. Le NASA-IBM Lunar Foundation Model a réduit les erreurs de 23 % par rapport à cette référence.
Les deux organisations ont également mesuré la capacité du modèle à identifier et classer les cratères. Là, le nouveau système a dépassé SwinV2-B de 19 % tout en utilisant deux fois moins de données d’entraînement.
Une validation sur un événement récent
Une occasion de vérification s’est présentée lorsqu’une fusée Falcon 9 de SpaceX s’est écrasée sur la Lune le 5 août. Lorsqu’IBM a soumis au modèle une image de l’impact, celui-ci a correctement identifié le site comme un nouveau cratère, malgré un chevauchement étroit avec un cratère préexistant. Juan Bernabé-Moreno indique que le modèle a réussi l’identification du premier coup.
L’entraînement du modèle a toutefois posé des difficultés spécifiques. En observation de la Terre, les images sont nettes : l’atmosphère diffuse la lumière solaire et remplit les ombres d’une lumière ambiante qui adoucit leurs contours. Sur la Lune, les ombres apparaissent au contraire aux bords tranchants et totalement noires, ce qui signifie que les pixels ombragés ne portent aucune information. Un cratère peut donc sembler différent d’une image à l’autre. S’ajoute une difficulté liée aux méthodes classiques d’entraînement des modèles de vision, qui consistent souvent à masquer une partie d’une image puis à demander au système de reconstituer la zone manquante. Cette approche ne fonctionne pas pour la Lune, car de nombreux cratères se ressemblent fortement lorsqu’ils sont photographiés depuis l’orbite. IBM indique que les tentatives d’entraînement traditionnelles ont échoué, avant qu’une solution ne soit trouvée : diviser la Lune en quartiers, à la manière d’une orange, et séparer complètement les quartiers d’entraînement des quartiers de test.
Un jeu de données ouvert de grande ampleur
La publication comprend un jeu de données open source inédit, destiné à la construction de futurs modèles. Il rassemble des dizaines de milliers d’images et des données instrumentales issues des missions Lunar Reconnaissance Orbiter (LRO) et Gravity Recovery and Interior Laboratory (GRAIL) de la NASA, ainsi que de la mission japonaise Selenological and Engineering Explorer (SELENE).
Selon Juan Bernabé-Moreno, l’absence antérieure d’un modèle lunaire complet et puissant s’explique par le fait que les données n’étaient pas organisées de manière exploitable. Le travail a consisté à créer une grille où chaque pixel de données d’imagerie correspond à d’autres modalités que le modèle peut utiliser pour guider son traitement. Le chercheur qualifie cette étape de contribution scientifique majeure, indépendamment du modèle lui-même : la communauté dispose désormais d’un jeu de données co-enregistré de plus de deux millions de points. Il souligne par ailleurs que les modèles d’IA sont voués à être remplacés, et que ce sont les données qui structurent durablement le domaine.
Ce qui est confirmé et ce qui reste inconnu
Les éléments disponibles confirment la publication du NASA-IBM Lunar Foundation Model en open source, sa disponibilité au téléchargement, l’existence d’un jeu de données associé, ainsi que les résultats comparatifs annoncés face à SwinV2-B : réduction de 23 % des erreurs pour la détection de glace, dépassement de 19 % pour la classification des cratères avec moitié moins de données d’entraînement. La validation sur l’impact du 5 août est également rapportée.
En revanche, plusieurs points ne sont pas précisés : la date exacte de l’annonce, la taille du modèle, ses conditions de licence, les modalités pratiques de téléchargement ou d’utilisation, ainsi que les caractéristiques matérielles requises pour l’exécuter. Aucune information n’est disponible sur d’éventuelles mises à jour ou sur les prochaines étapes prévues par la NASA et IBM.